
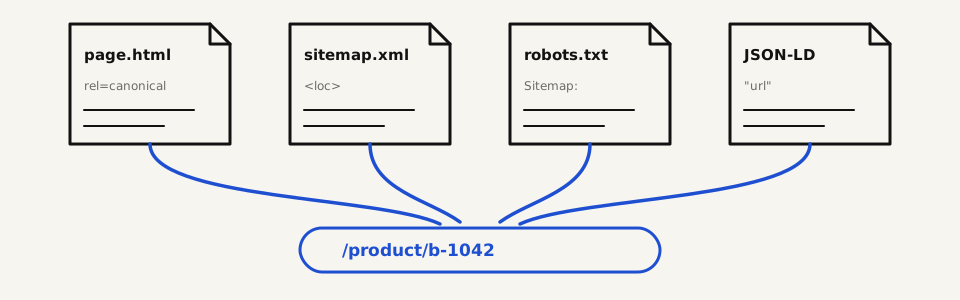
Le premier problème SEO sur un ecommerce ne commence presque jamais dans Search Console. Il commence plutôt quand une URL dit qu'une page existe, que le sitemap affirme qu'elle compte, que le balisage raconte autre chose, et que le catalogue n'arrive pas à arbitrer.
Problème
Le SEO technique est encore trop souvent traité comme un sujet de plugin. En pratique, c'est un sujet de structure de l'information avec des conséquences SEO.
Sur une plateforme ecommerce, plusieurs couches sont censées raconter la même histoire :
- la route qui expose une page ;
- l'URL canonique qui dit quelle version compte ;
- le sitemap qui déclare ce qui mérite d'être découvert ;
- les données structurées qui rendent la page lisible pour les robots ;
- la donnée produit qui nourrit prix, disponibilité, images et taxonomie.
Quand ces couches divergent, l'échec n'a rien d'abstrait. Les moteurs reçoivent des signaux contradictoires. Les équipes ne savent plus si le problème vient du markup, du routage ou du catalogue. Et le travail SEO devient réactif, parce qu'aucune surface n'est clairement souveraine.
Décision
La décision consiste à traiter le SEO technique d'abord comme un problème de format.
Cela veut dire garder proches le routage, les canoniques, les règles robots et la génération du sitemap. Dans ce repo, même la sortie robots.txt reste explicite au lieu d'être déléguée à un défaut d'hébergement :
$content = implode(PHP_EOL, [
    'User-agent: *',
    'Allow: /',
    'Sitemap: '.url('/sitemap.xml'),
]);
La même logique vaut pour le sitemap. Une route doit y apparaître parce qu'elle est publique et canonique, pas parce qu'un fichier existe quelque part ou qu'une page a été liée une fois par hasard.
L'alternative, c'est la dérive classique : un outil gère les redirections, un autre sort le markup, un autre génère des feeds, et plus personne ne peut dire quelle couche a le dernier mot. Cela tient jusqu'au moment où catalogue, locales et pages éditoriales commencent à se croiser. Ensuite, chaque correctif SEO tourne à l'enquête.
Résultat
Quand ces surfaces partagent le même contrat, le SEO technique devient plus calme.
On peut raisonner sur le site avec moins de règles cachées. Une page est publique parce que l'application l'a décidée. Elle est canonique parce que le même runtime le dit. Elle entre dans le sitemap parce que le même modèle de lecture l'expose. Les données structurées deviennent alors la dernière expression d'une décision déjà cohérente en amont.
C'est particulièrement important en ecommerce, parce que les données structurées ne vivent jamais seules. Un Product propre n'a de valeur que si l'URL est stable, si la page est indexable, si l'image est exploitable, et si la disponibilité vient d'une donnée produit que l'équipe métier peut assumer.
C'est pour cela que ce sujet rejoint Schema.org, rich results et images produit. La couche markup ne reste crédible que si les couches basses sont alignées.