
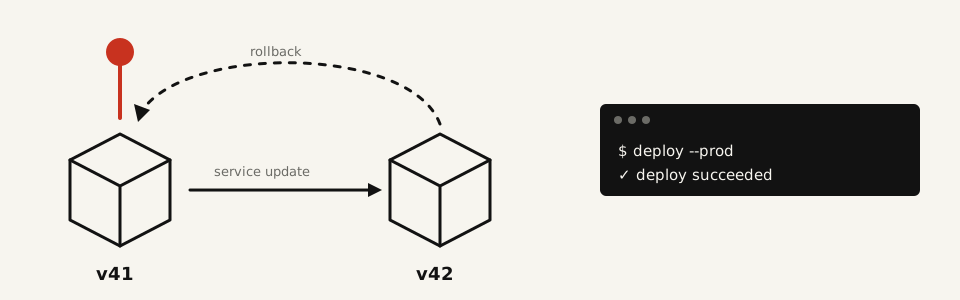
Le problème ne commençait pas dans le code applicatif. Il commençait au moment précis où un déploiement automatique annonçait un succès alors qu'un Docker Swarm rollback silencieux laissait parfois la production sur l'image précédente.
Problème
Le cas rencontré côté client était simple à résumer et pénible à diagnostiquer. Un docker service update se passait sans bruit, le job CI restait vert, puis le service repassait parfois sur l'ancienne image après un rollback automatique. À la lecture du pipeline, le correctif semblait livré. En production, rien n'avait vraiment changé.
Ce type de faux positif coûte cher. Il abîme la confiance dans l'outillage, la lecture des incidents et la coordination d'équipe. On peut commencer à déboguer au mauvais endroit, ou annoncer une correction alors que la bonne image n'a jamais été effectivement prise en compte.
Décision
La décision n'a pas été de tout reconstruire. Elle a consisté à rendre le pipeline honnête sur l'état final du service.
Concrètement, cela veut dire vérifier l'image réellement retenue après le déploiement, et pas seulement le retour de la commande :
expected_image="$REGISTRY/$APP_IMAGE:$IMAGE_TAG"
service_name="$APP_SERVICE"

docker service update \
  --with-registry-auth \
  --image "$expected_image" \
  "$service_name"

current_image="$(docker service inspect "$service_name" \
  --format '{{.Spec.TaskTemplate.ContainerSpec.Image}}')"

if [[ "$current_image" != *"$IMAGE_TAG"* ]]; then
  echo "Rollback or stale image detected: $current_image"
  exit 1
fi
L'autre décision importante consistait à traiter certains facteurs déclencheurs, comme la pression disque, avant de continuer à lire le pipeline comme s'il s'agissait d'une pure question CI. Cela passait aussi par une réflexion plus propre sur la rétention des images et sur ce qu'une ECR lifecycle policy devait éviter d'accumuler entre deux déploiements. L'alternative aurait été de garder le même signal vert et d'ajouter des vérifications humaines autour. Cela aurait déplacé le problème au lieu de le résoudre.
Résultat
Le premier résultat n'a pas été visuel. Il a été opérationnel. Le pipeline a cessé d'être une simple suite de commandes pour redevenir un témoin fiable de l'état final.
Dans un contexte ecommerce, c'est essentiel. Quand un correctif catalogue, front ou tunnel d'achat doit arriver vite, l'équipe ne peut pas perdre une heure à se demander si le bon code tourne vraiment. Un pipeline utile n'est pas un pipeline impressionnant. C'est un pipeline qui rend la réalité plus lisible.
J'aime bien ce type de correction parce qu'elle remet le sujet à la bonne échelle. Il ne s'agissait pas de bâtir une chaîne plus spectaculaire. Il s'agissait de réduire l'écart entre le signal affiché et l'état réellement déployé. C'est souvent là qu'une partie importante du travail de fiabilité se joue.
Cette réflexion prolonge directement le cas d'étude Vérifier ce qui tourne vraiment après un déploiement e-commerce, où le problème et le durcissement sont racontés à l'échelle du projet.